27 октября — 2 ноября 2026. Девять практик для работы с coding-агентами: контекст, проверки и инструменты, которые можно испытать на одном проекте.
9 выводов72 поста прочитаны20 каналов в сборе
Что важно на этой неделе
На этой неделе полезнее всего оказались способы проверить самого агента. Транскрипт показывает, какое правило он нарушил; свежая сессия — чему действительно научил скилл. Повторные eval отделяют улучшение от удачной попытки. А для оптимизации кода нужен измеримый результат и проверка, что выбранная метрика отражает реальную задержку.
Суть: debrief разбирает сохранённые сессии Claude Code, сверяет инструкции с памятью и предлагает место для исправления. Если запрет уже был в контексте, его можно закрепить средствами permissions или hook.
Почему важно: Новая строка в CLAUDE.md не устраняет конфликт со старой автопамятью. Сначала нужно найти правило, которое действительно управляло ошибочным ходом.
Как применить
Выберите одну повторяющуюся поправку и разберите её контекст в транскриптах с помощью debrief из the-workflow.
Сведите спорящие инструкции к одному правилу. Для запрета действия проверьте permission; для условия по пути или флагу — PreToolUse-hook.
Прогоните hook по прошлым вызовам: он должен остановить ошибочный вызов и пропустить допустимые.
Риск / ограничение: Предложения модели требуют проверки. Модельный replay — отдельный платный опыт по запросу; он не равен прогону hook по журналу.
Суть: Остриков сначала доводит задачу до рабочего результата в диалоге, затем оформляет скилл. Настоящая проверка начинается в новой сессии: агент должен повторить процесс без накопленного контекста.
Почему важно: Правильный ответ может скрывать десятки ненужных действий. Порядок вызовов показывает, где инструкция оставила агенту лишние развилки.
Как применить
Возьмите одну повторяемую задачу и оформите успешно найденный процесс в скилл. Запустите её в новой сессии.
Попросите выписать по порядку вызванные инструменты, использованные данные и передачи между шагами. Исправьте лишний переход в логике скилла.
Повторите тот же сценарий: сравните правильность результата, число вызовов и время.
Риск / ограничение: Наблюдение автора об ускорении не задаёт ожидаемый результат для других задач. Убирать проверки ценой правильности нельзя.
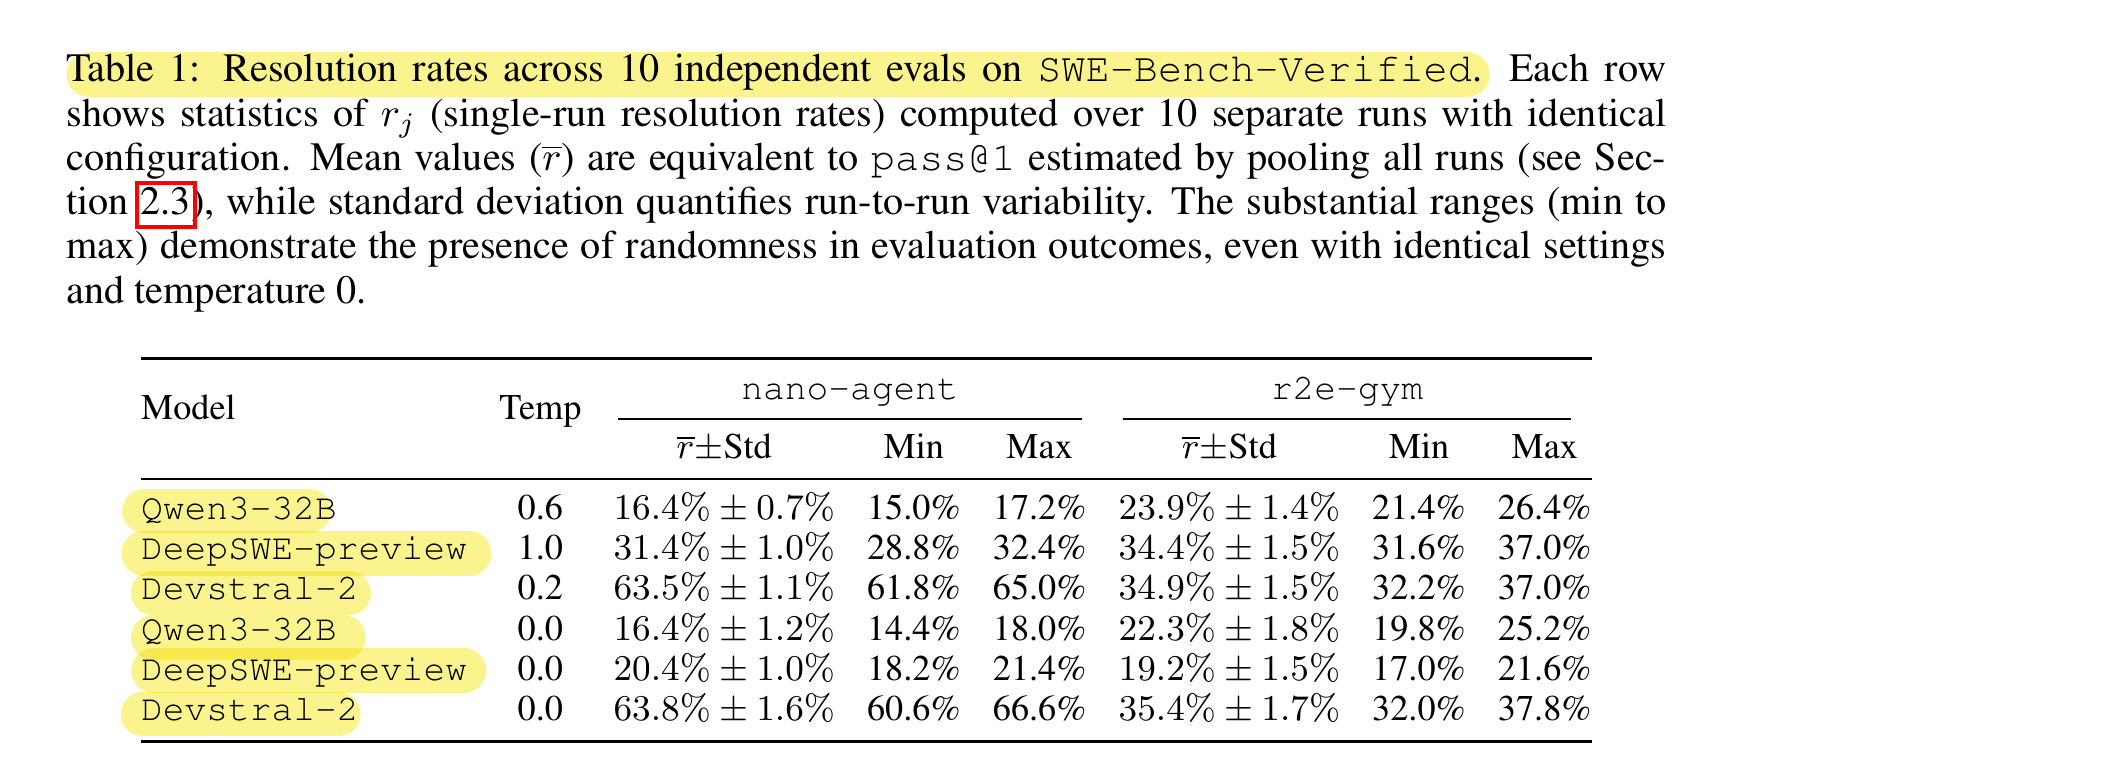
Суть: В разборе On Randomness in Agentic Evals разница между худшим и лучшим из десяти одинаковых прогонов составила 2,2–6 процентных пунктов. Нулевая температура не устранила разброс.
Почему важно: Пара дополнительных решённых задач может оказаться удачным прогоном. Смена модели или инструкций нуждается в сравнении нескольких попыток на одинаковых задачах.
Как применить
Зафиксируйте набор задач, конфигурацию и минимальную прибавку, ради которой вы готовы менять агента.
Повторите обе конфигурации на тех же задачах. Сохраните не только успехи, но и провалы и затраты.
Покажите средний результат и разброс. Число повторов выбирайте под нужный эффект и бюджет.
Риск / ограничение: Десять прогонов — устройство исследования, а не универсальная норма. Работа не проверяла агентов со сжатием истории.
Таблица из приложенного PDF: даже при temperature=0 Devstral-2 с nano-agent решал от 60,6% до 66,6% задач. Разница 6 п. п. возникла без изменения агента.
Суть: Разбор Evaluating AGENTS.md предлагает проверять добавочную пользу инструкций. В описанном исследовании автогенерация увеличила стоимость, но значимого улучшения успешности не показала.
Почему важно: Обзор репозитория может заставить агента больше читать, не помогая найти нужный код. Уникальные требования к задаче и безопасности нужно оценивать отдельно.
Как применить
В экспериментальной копии AGENTS.md отметьте дубли README и документации. Сохраните уникальные ограничения и критерии готовности.
Сравните исходный и сокращённый варианты на одинаковых задачах при одной конфигурации агента.
Проверьте принятые патчи, затраты и соблюдение ограничений; не считайте прохождение тестов полной оценкой качества.
Риск / ограничение: Исследование проводили на Python. Отдельный эффект удаления дублей не доказан; для Go это проверка гипотезы, а не обещание выигрыша.
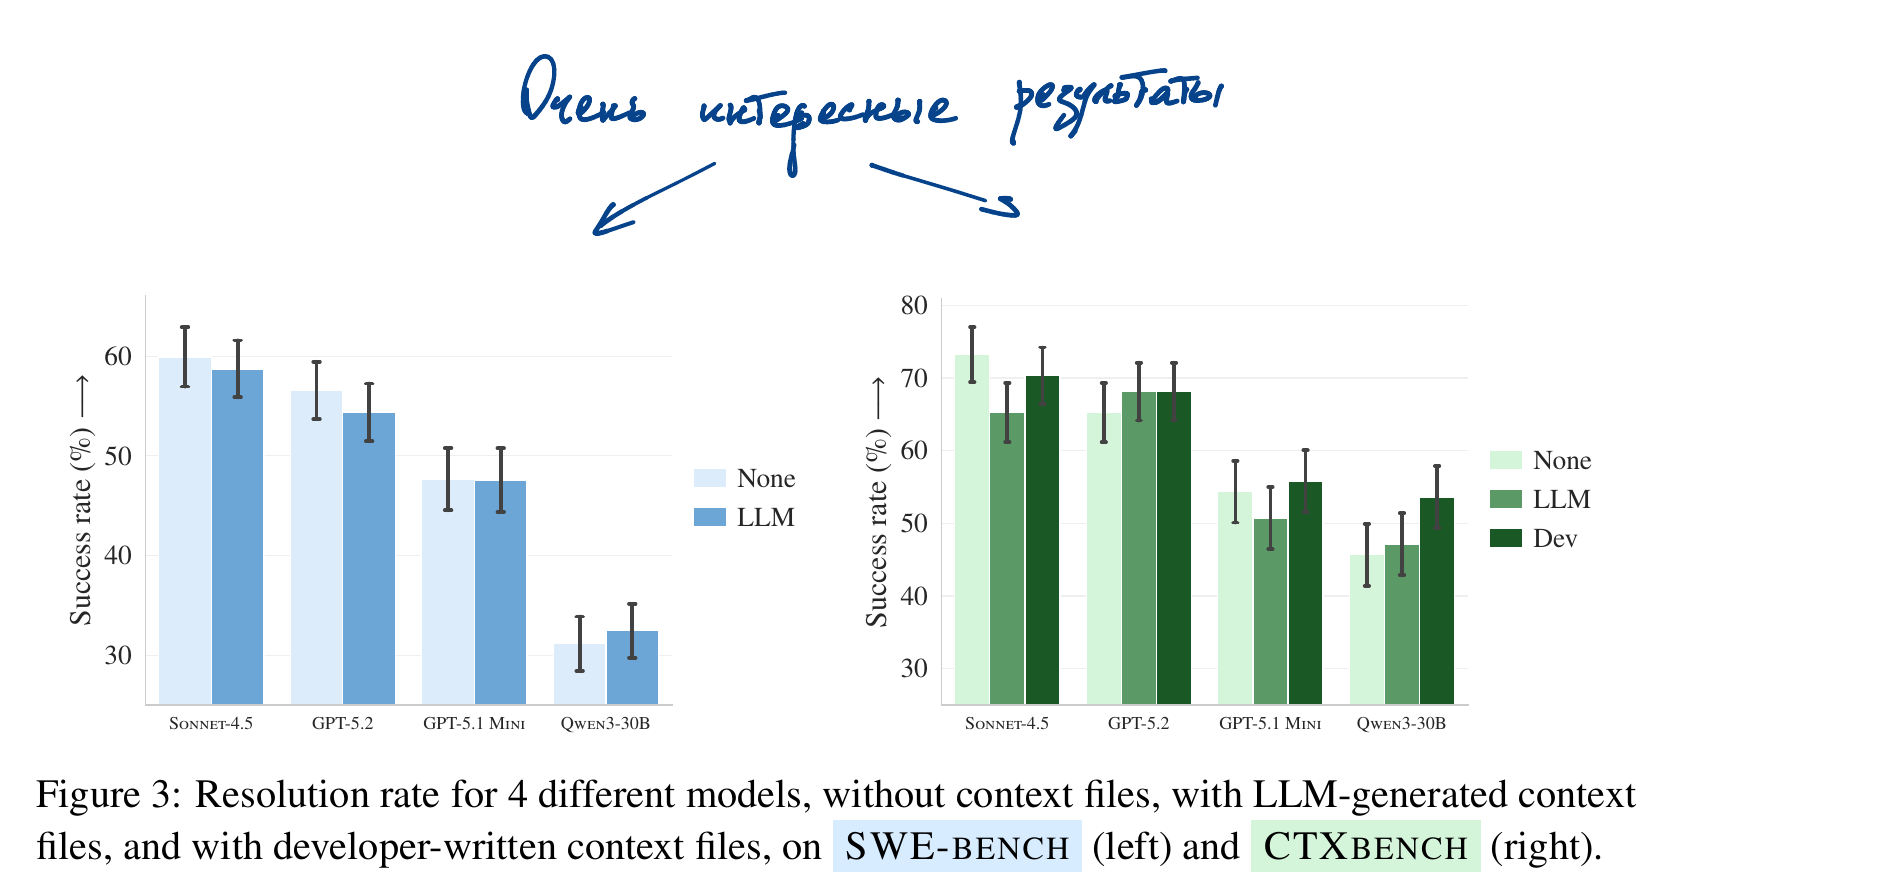
Figure 3 из приложенного PDF: None — без контекстного файла, LLM — с автогенерацией, Dev — с инструкциями разработчиков. Слева SWE-bench, справа CTXBench; общего выигрыша для всех связок нет.
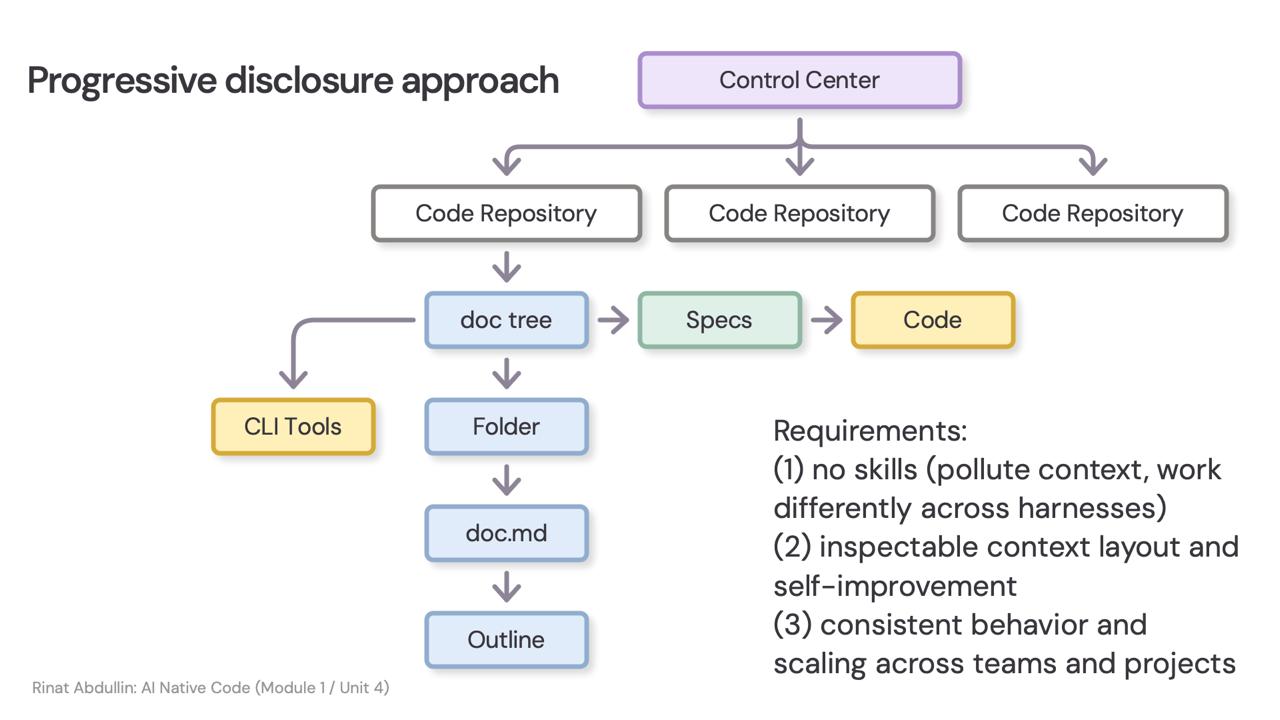
Суть: Ринат Абдуллин показывает progressive disclosure: агент раскрывает документы по мере задачи. На схеме дерево репозитория ведёт к отдельному документу и его оглавлению, а также к спецификации и коду.
Почему важно: Так можно проверить управляемую загрузку знаний на одном модуле, вместо передачи всей документации в каждый запрос.
Как применить
Для одного модуля сделайте индекс документов со ссылками на подробные разделы. Отдельно обозначьте путь к спецификации и коду.
Дайте агенту задачу и попросите начать с индекса, раскрывая только нужные документы.
Сравните с прежним способом на той же задаче: какие файлы прочитаны, какие требования пропущены и принят ли результат.
Риск / ограничение: В посте нет готовых файлов, команд загрузки или протокола сравнения со skills. Подтверждены схема и подход; предложенный опыт ещё нужно провести.
Исходная схема: Control Center → репозитории → doc tree → Folder → doc.md → Outline. От дерева также идут CLI Tools и Specs → Code.
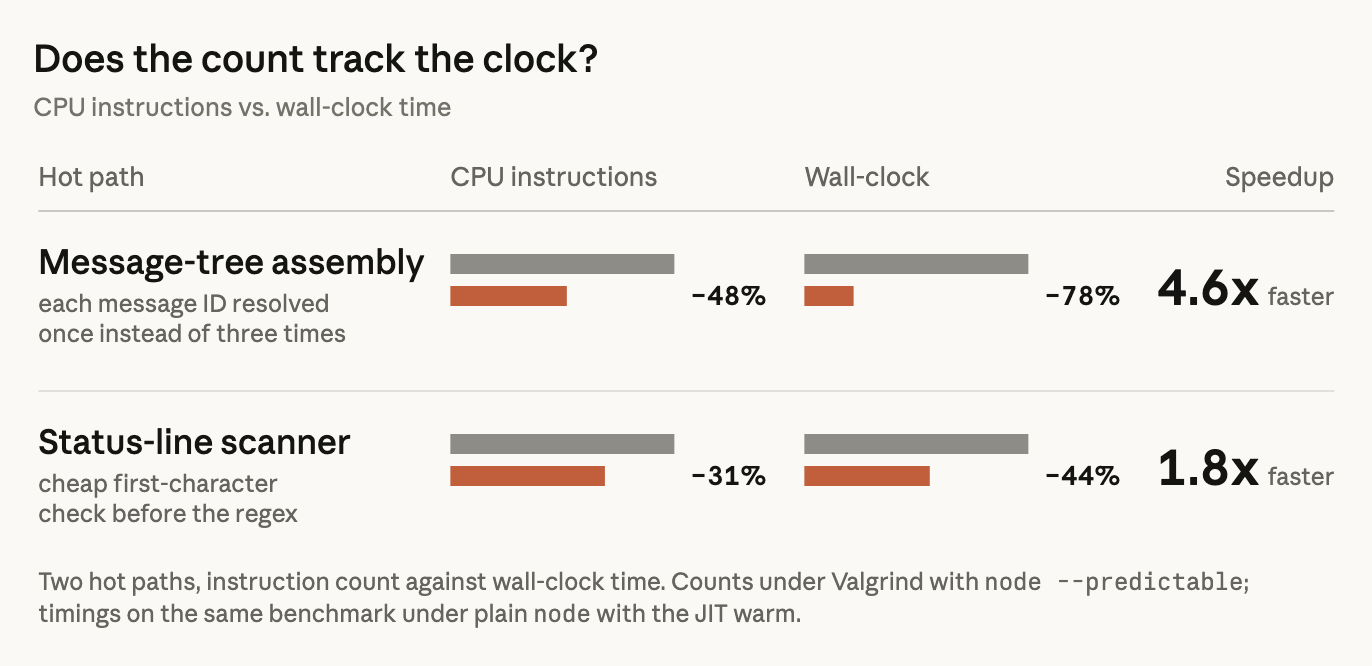
Суть: Anthropic описали цикл: найти узкое место, построить benchmark, проверить изменение и закрепить результат регрессионным барьером. Важный шаг — доказать, что выбранный счётчик связан с задержкой, которую чувствует пользователь.
Почему важно: Агент может оптимизировать число, которое легко уменьшать, но которое ничего не меняет для сервиса. Поэтому метрика требует проверки до автоматического запрета регрессий.
Как применить
Выберите один горячий путь Go-сервиса и зафиксируйте воспроизводимый benchmark и пользовательскую задержку.
Поручите агенту найти узкое место и предложить небольшой патч с проверкой человеком.
Сверьте изменение стабильного счётчика с задержкой. Добавляйте CI-барьер только для метрики, связь которой подтверждена.
Риск / ограничение: Кейс относится к клиентскому приложению. Выигрыш Anthropic нельзя переносить на Go; шумное время выполнения само по себе плохо подходит для жёсткого CI-порога.
График Anthropic: в двух горячих путях снижение числа инструкций сопровождалось снижением времени. Связь проверяли на одном benchmark, а не предполагали заранее.
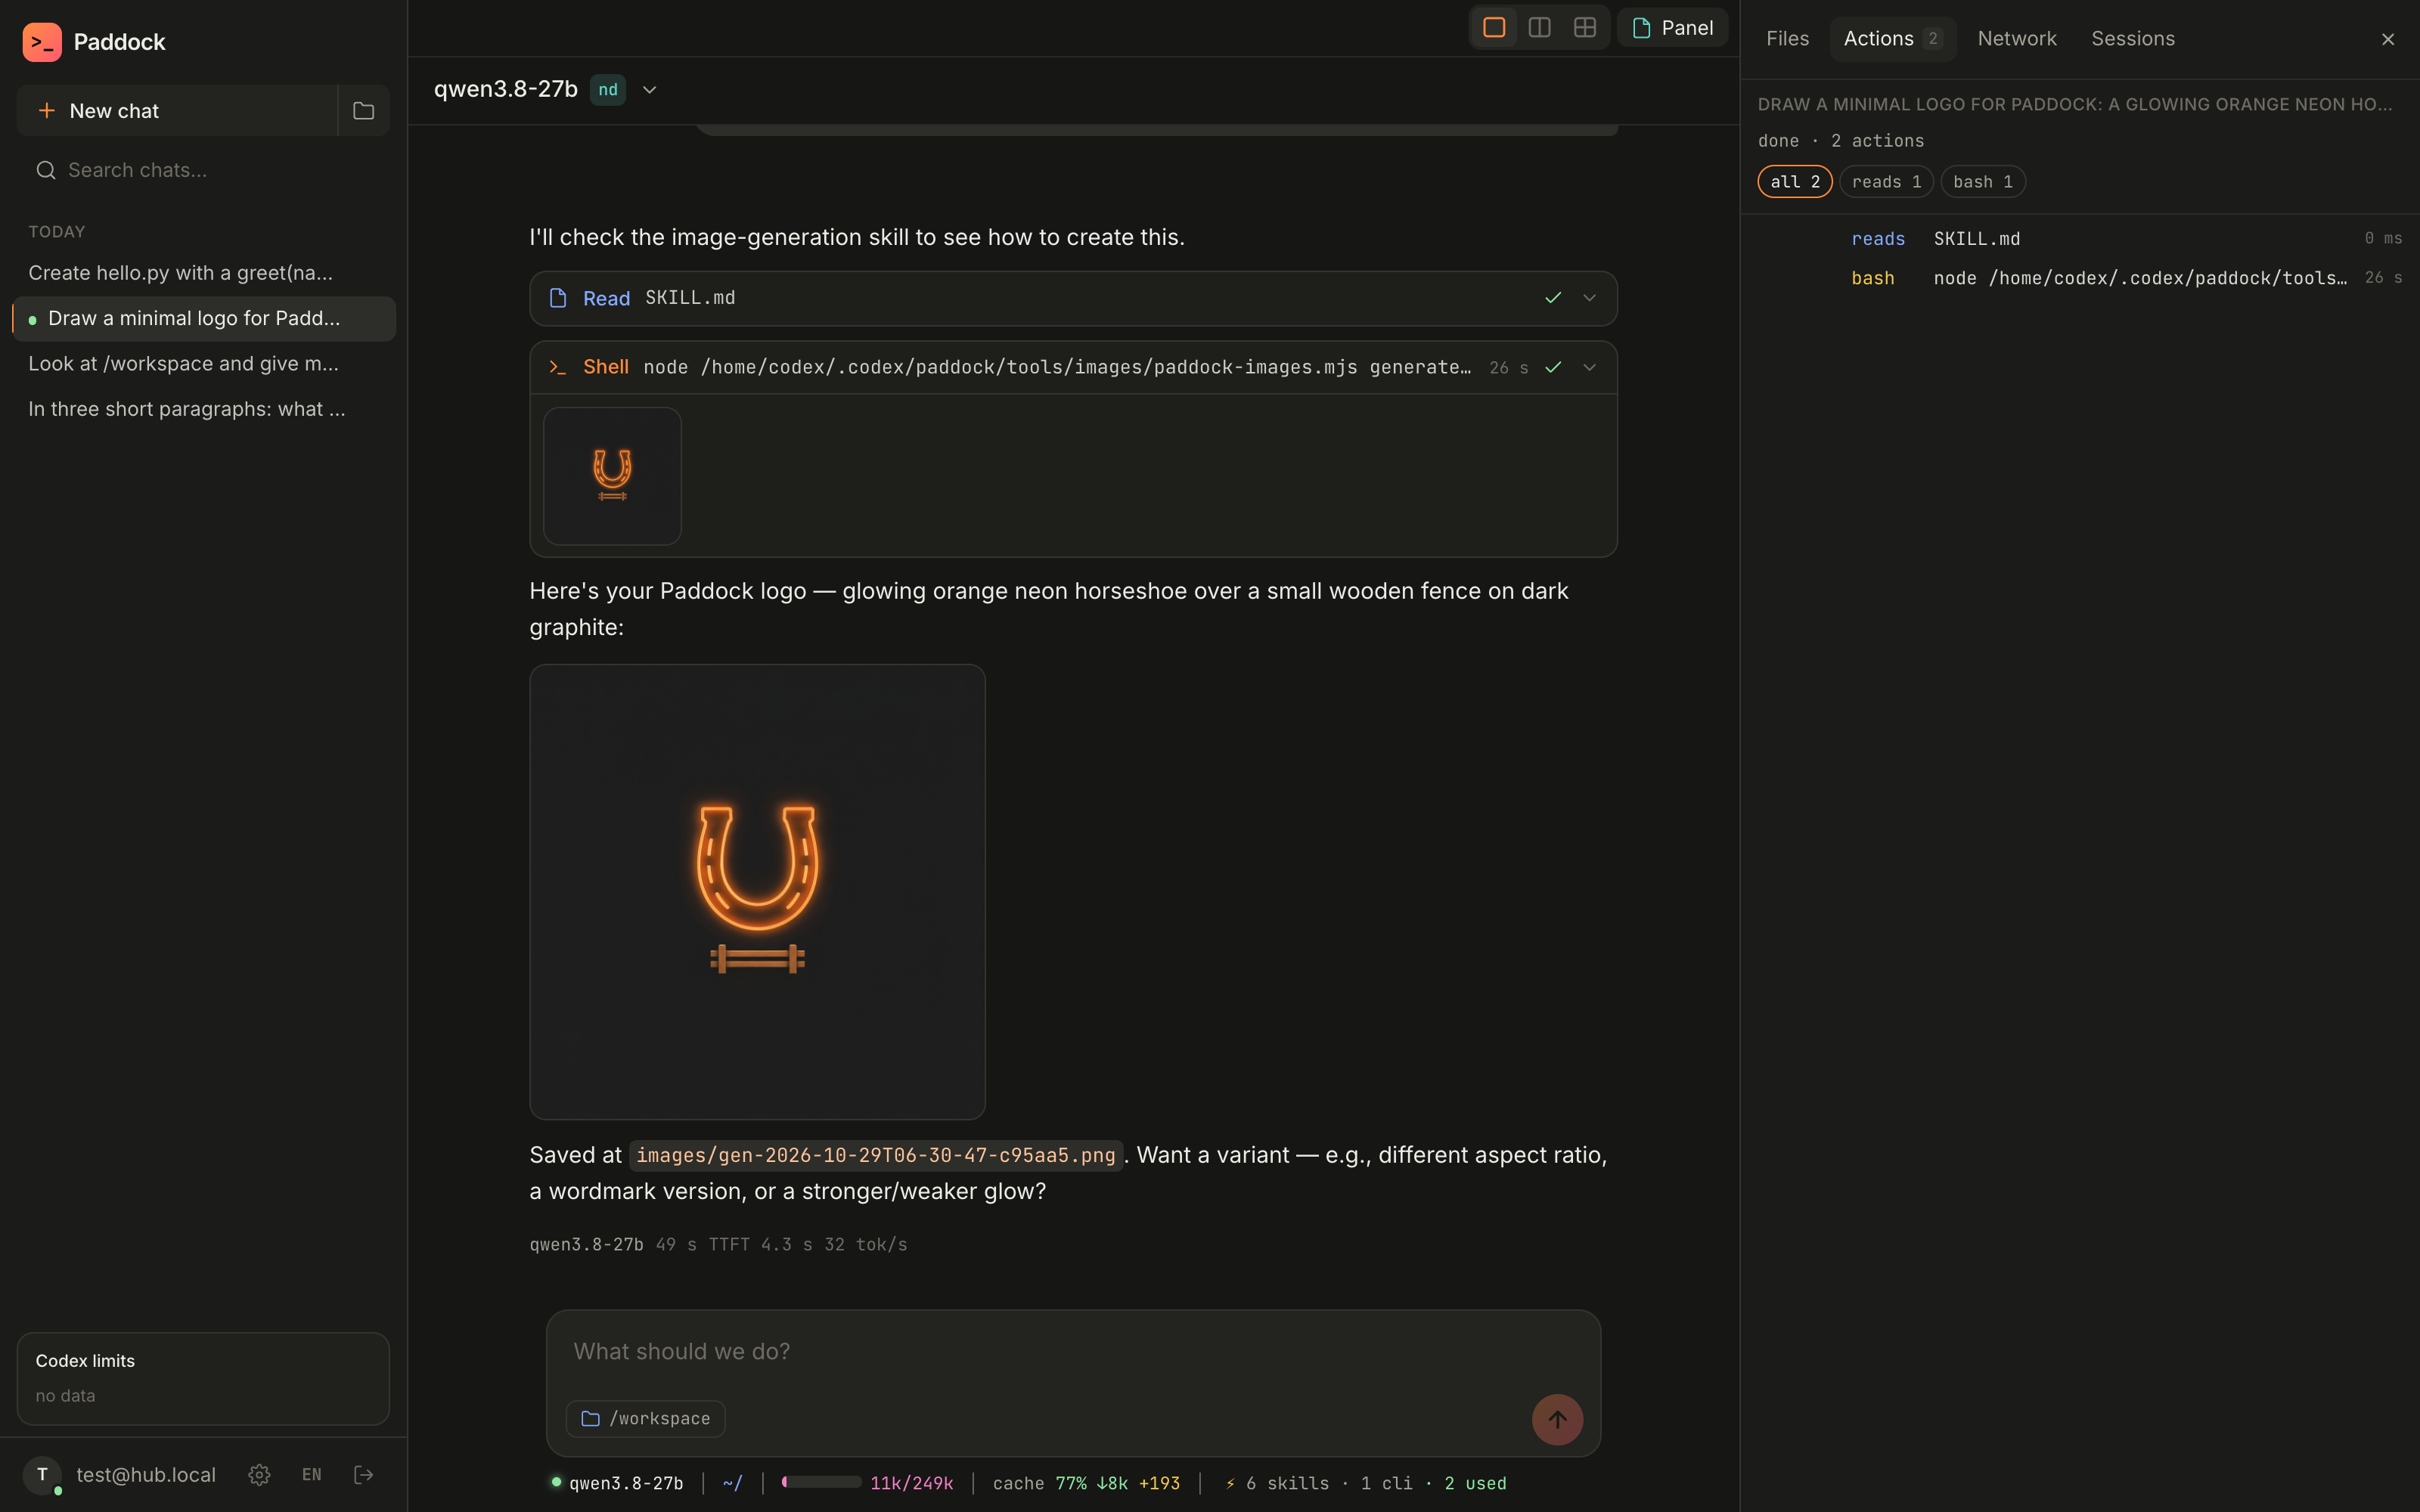
Суть: Paddock переносит coding-агентов в контейнеры на сервере и открывает их через веб-интерфейс. В README есть отдельный контейнер на пользователя, лента действий, 2FA и подтверждения опасных команд.
Почему важно: Такой вариант закрывает конкретный сценарий: продолжать видеть работу с другого устройства и не привязывать выполнение к открытому ноутбуку.
Как применить
Поднимите тестовый Paddock по README с одним пользователем и одноразовым репозиторием без рабочих секретов.
Запустите короткую задачу, переподключитесь с другой вкладки и проверьте сохранение состояния и ленту действий.
Убедитесь, что опасная команда требует подтверждения, а контейнер не получает прямой доступ к хосту и LAN.
Риск / ограничение: Это авторский эксперимент. Сейчас работает адаптер Codex; изоляцию, восстановление и подтверждения нужно принимать по собственным проверкам.
Скриншот README: справа Actions показывает чтение SKILL.md и shell-вызов. Внизу видны модель, контекст, кеш и использованные инструменты.
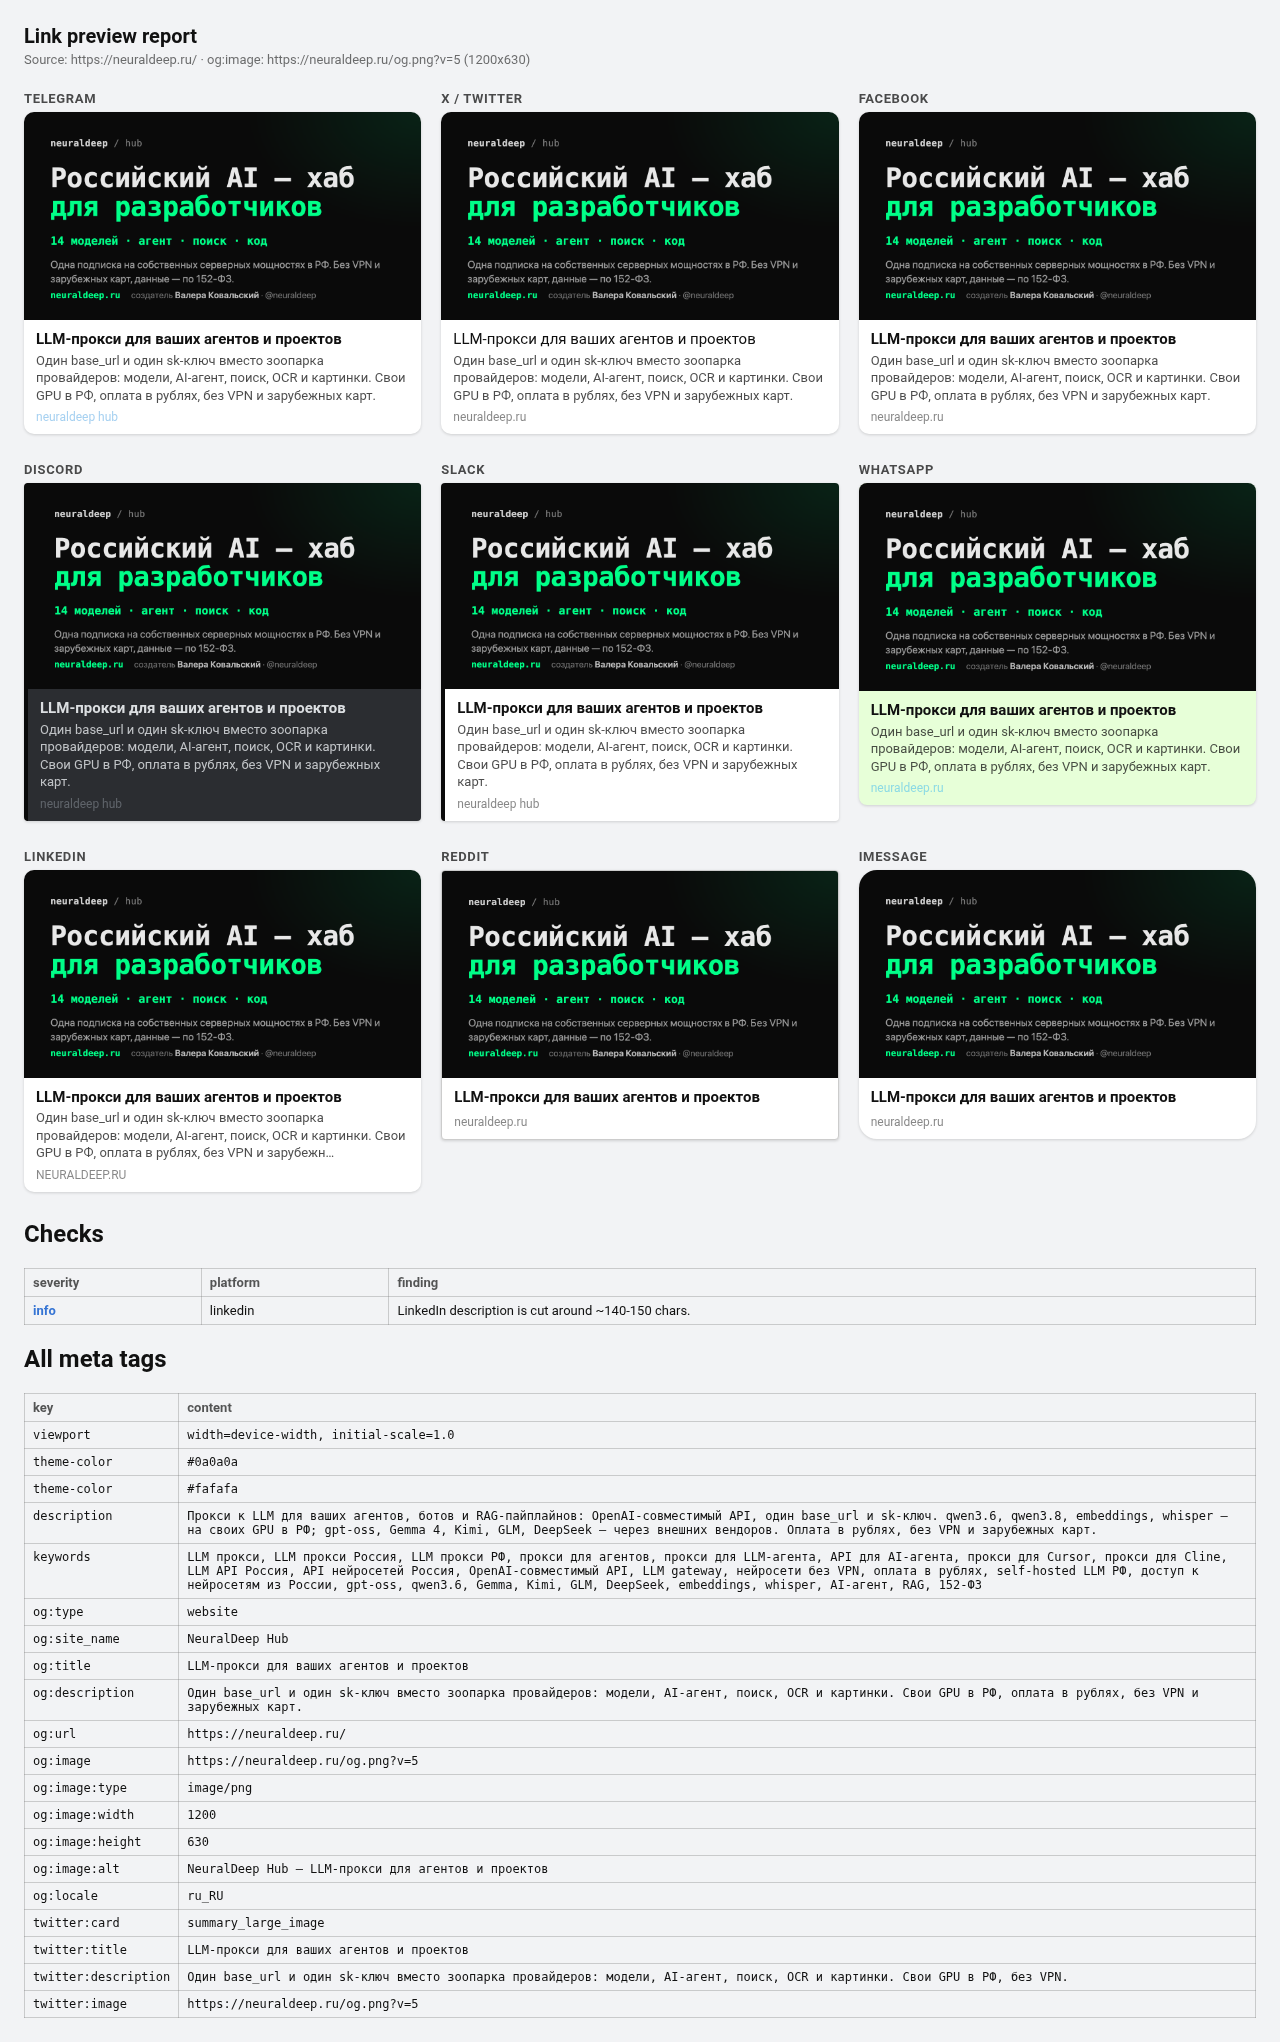
Суть: og-preview строит HTML-отчёт с моками карточек девяти платформ и замечаниями к метатегам. Он принимает URL локального сервера или готовый HTML-файл; внешний валидатор не нужен.
Почему важно: Можно проверить заголовок, описание и ссылку на изображение до публикации страницы, к которой публичный crawler ещё не имеет доступа.
Как применить
Передайте агенту локальный URL или HTML-файл и попросите запустить og-preview. В README есть команда python3 scripts/og_preview.py http://localhost:3000/blog/post.
Исправьте находки: недоступное изображение, неверные размеры или обрезающийся текст.
Повторите отчёт и проверьте findings. Код завершения 1 при ошибках позволяет добавить проверку в CI.
Риск / ограничение: Это моки правил платформ. Они не гарантируют одинаковый реальный рендер или обновление кеша Telegram после публикации.
Пример отчёта из README: девять вариантов карточки, таблица проверок и найденные метатеги. Для LinkedIn отчёт отмечает риск обрезки описания.
Суть: plugin-rollcall проверяет загрузку плагинов Claude Code и вызывает перезагрузку, если часть не появилась. Автор прямо ограничивает решение интерактивными сессиями.
Почему важно: Установленный плагин ещё не означает, что текущая сессия видит его скиллы. Эту предпосылку нужно проверять перед задачей, которая на них опирается.
Как применить
В отдельной интерактивной сессии Claude Code выпишите ожидаемые плагины и доступные скиллы.
Если воспроизводится описанный сбой, проверьте plugin-rollcall@foundry по источнику и повторите сверку после восстановления.
Проверьте, что нужный скилл теперь вызывается. Отдельно учтите пропущенные startup hooks.
Риск / ограничение: В посте нет команды установки. Перезагрузка не возвращает уже пропущенные хуки старта и не решает задачу неинтерактивных сессий.
Прочитаны все 72 поста собранного корпуса. В основные карточки вошли 9; ещё 25 остались на радаре отбора, из них выше показаны четыре. Отклонены 38: афиши, реклама, мемы, общие рассуждения и материалы без подтверждённого действия. При сборе отдельно сняты пять точных повторов между каналами и восемь сообщений без подписи.
План на неделю
Разобрать одну повторяющуюся поправку по транскриптам и проверить исполняемое ограничение.
до среды
Повторить одну задачу новым скиллом в свежей сессии и убрать лишний переход.
до четверга
Сравнить две конфигурации агента на фиксированных задачах с повторными прогонами.
до пятницы
Метаданные
Сбор: 2026-11-02T07:43:37.270053Z
Окно: 27 октября — 2 ноября 2026, семь полных суток UTC. Источник: живой tdl chat export, последовательно по chat_id.
Из 20 каналов посты были у 18. Молчали AI RANEZ и Aimasters.Me. Недоступных каналов нет.
Источник старше недели может попасть сюда через новый Telegram-пост; дата карточки относится к посту. Эффект предлагаемых экспериментов не измерялся редакцией.