27 октября — 2 ноября 2026. Агент повторяет ошибку, долго решает простую задачу или показывает случайный прирост в eval. В этом выпуске — девять способов найти причину и проверить изменение на своём проекте.
9 выводов72 поста прочитаны20 каналов в сборе
Что важно на этой неделе
Повторная ошибка агента не всегда означает, что ему не хватает ещё одного правила. В записях сессий может обнаружиться конфликт с памятью, а проверка skill в новой сессии покажет, какие действия инструкция описывает плохо. Для сравнения моделей нужны повторные eval, для ускорения кода — метрика, связанная с задержкой пользователя, и проверка регрессий в CI. Начать можно с одной задачи, где результат удастся проверить.
Что можно проверить на своём проекте
01
Найти причину повторных ошибок агента в записях сессий
Суть: Агент пять раз пропустил локальное ревью перед push, хотя правило уже было в его контексте. Автор написал debrief — skill из плагина the-workflow для Claude Code. Он читает сохранённые записи сессий, находит повторяющиеся поправки и сверяет их с инструкциями и памятью агента.
Почему важно: Ещё одна запись правила не устраняет конфликт со старой заметкой в автопамяти. debrief предлагает исправить конфликт, перенести правило в подходящий файл или закрепить запрет через правила разрешений permissions или hook.
Как применить
В своём проекте можно начать с одной повторяющейся ошибки: разобрать её через debrief и проверить предложенное исправление по записи сессии.
Сведите конфликтующие инструкции к одному правилу. Запрет действия можно закрепить через permissions, а условие по пути или флагу — через PreToolUse-hook, который срабатывает перед вызовом инструмента.
Попросите debrief проверить hook на прошлых вызовах: ошибочный вызов должен блокироваться, допустимые — проходить.
Ограничение: Предложения формирует модель; перед изменением инструкций их проверяет человек. Отдельный replay с моделью переигрывает ход с новым правилом, стоит денег и запускается только по запросу. Проверка hook по журналу не требует такого replay.
Суть: В долгом диалоге агент научился решать задачу, но часть нужных сведений могла остаться только в переписке. Остриков оформляет найденный процесс в skill, затем повторяет задачу в новой сессии. Даже при правильном ответе он разбирает порядок вызовов инструментов и убирает лишние действия из логики skill.
Почему важно: Так становится видно, чему научила инструкция, а что агент заново выясняет обходным путём. Правильного ответа недостаточно, если ради него выполняются десятки ненужных вызовов.
Как применить
Для проверки своего skill возьмите одну повторяемую задачу, которую уже удалось решить в диалоге. Запустите её с этим skill в новой сессии.
Попросите перечислить вызовы инструментов по порядку: какие данные каждый вернул и где агент их использовал. Уточните логику skill там, где обнаружился лишний переход.
Повторите тот же сценарий и сравните правильность ответа, число вызовов и время.
Ограничение: Автор наблюдал ускорение на своих задачах, но оно не задаёт ожидаемый результат для других skill. При сокращении цепочки нужно сохранить проверки правильности.
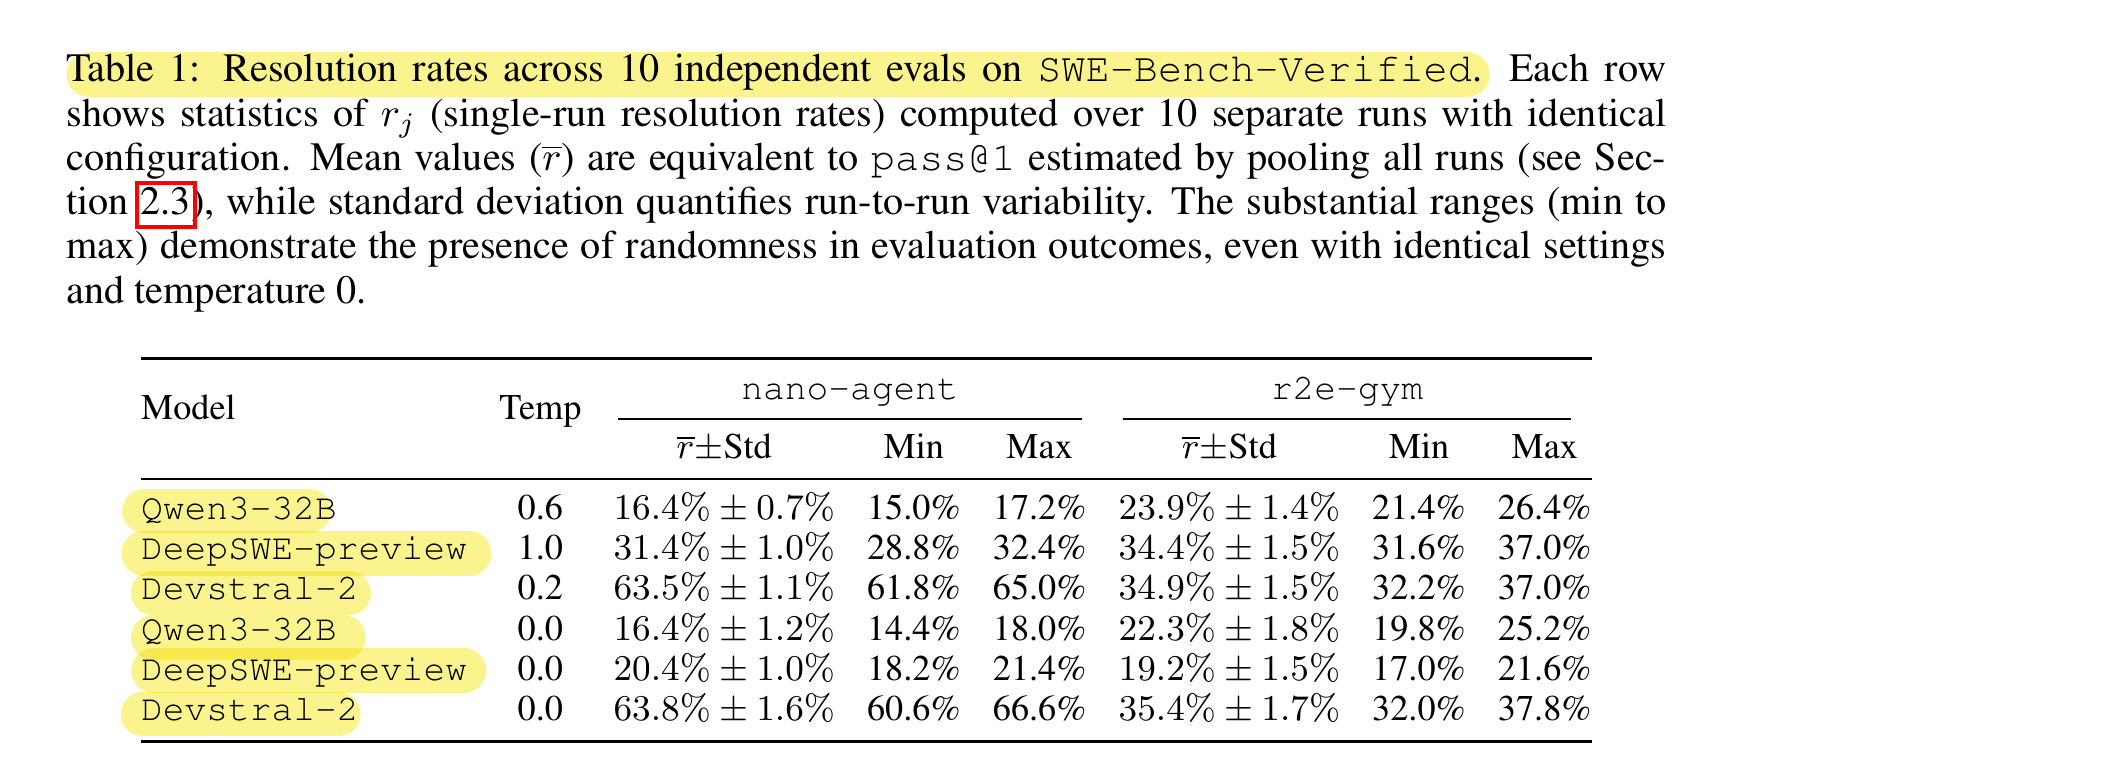
Суть: Если после смены модели агент решил больше задач, один прогон ещё не доказывает улучшение. В исследовании On Randomness in Agentic Evals худший и лучший из десяти одинаковых прогонов различались на 2,2–6 процентных пунктов. Разброс сохранялся и при нулевой температуре.
Почему важно: Eval — проверка агента на наборе задач — тоже даёт шумный результат. Авторы рекомендуют повторять попытки и показывать разброс, чтобы отличать изменение агента от удачного запуска.
Как применить
В своём сравнении зафиксируйте набор задач, обе конфигурации и минимальную прибавку, ради которой готовы менять агента.
Повторите обе конфигурации на тех же задачах. Сохраните успехи, провалы и затраты.
Покажите средний результат и разброс. Число повторов выбирайте под нужный эффект и бюджет.
Ограничение: В исследовании каждую конфигурацию запускали десять раз; это не универсальная норма. Агентов со сжатием истории в работе не проверяли.
Таблица из приложенного PDF: при temperature=0 Devstral-2 с nano-agent решал от 60,6% до 66,6% задач. Разница 6 п. п. возникла без изменения агента.
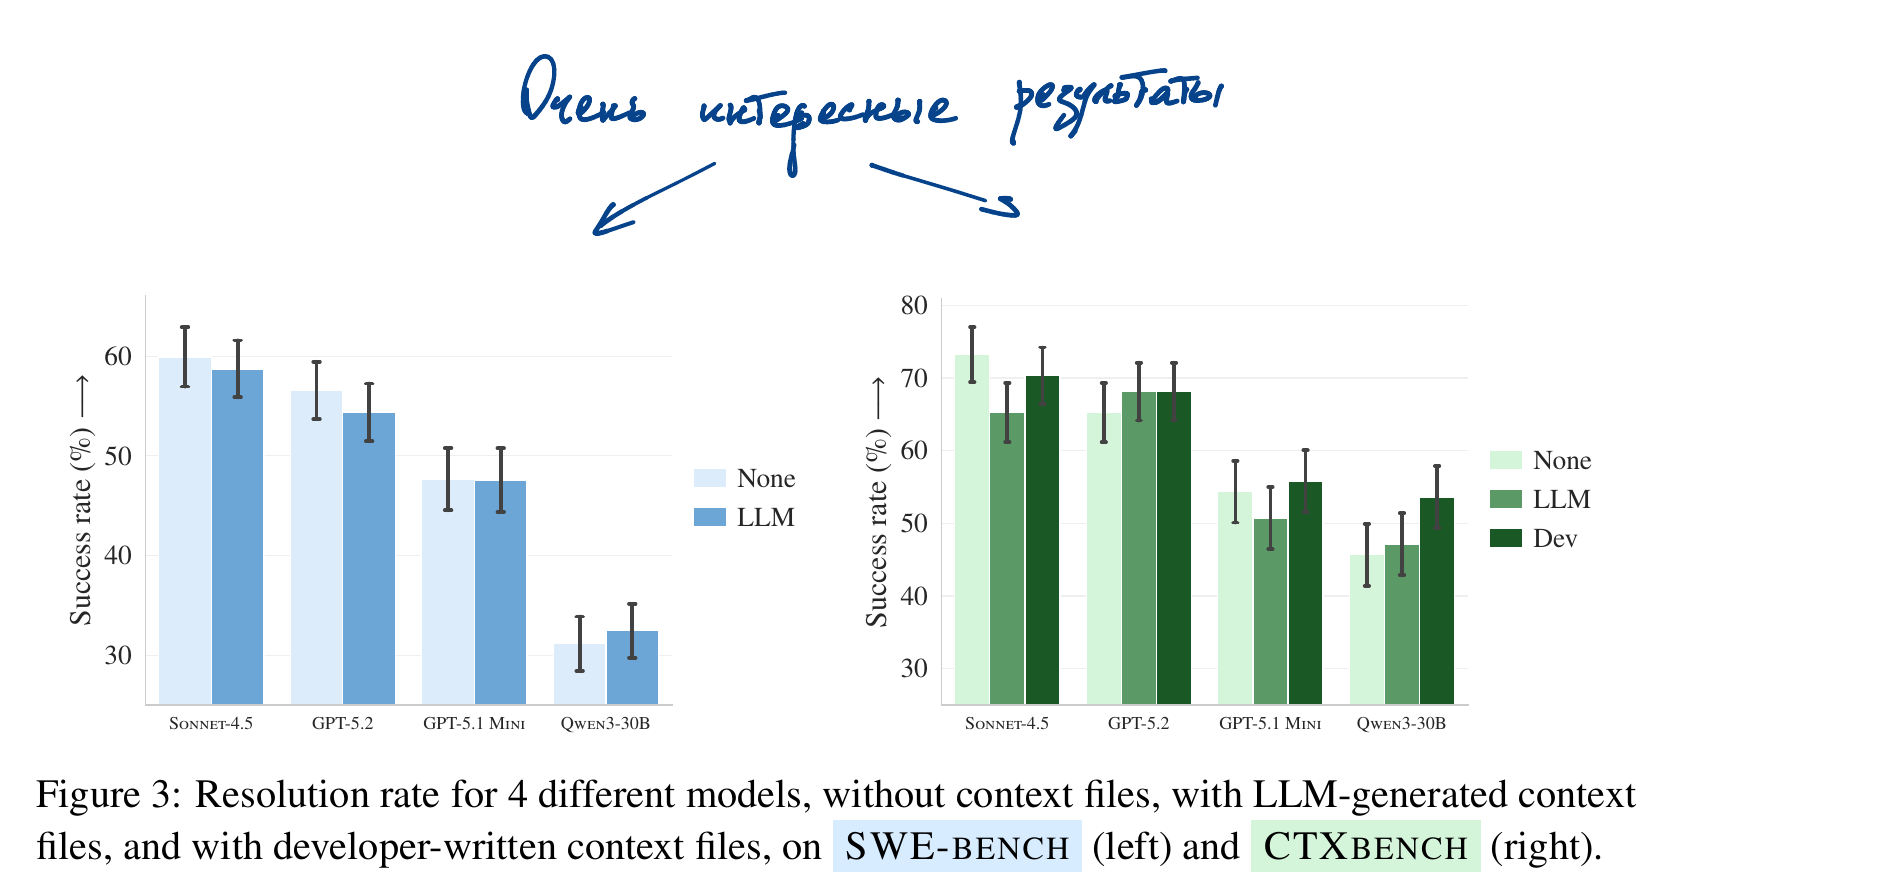
Суть: Файл AGENTS.md может заставить агента больше читать и тестировать, не увеличивая число решённых задач. В исследовании Evaluating AGENTS.md сгенерированные инструкции повысили стоимость работы, но статистически значимого улучшения успешности не дали. Авторы рекомендуют оставлять требования, которых нет в документации, и проверять их пользу экспериментом.
Почему важно: Обзор репозитория дублирует сведения, которые агент и так может прочитать. При этом правила безопасности и архитектуры требуют отдельной оценки: прохождение тестов на патче не показывает, соблюдены ли они.
Как применить
В своём проекте можно сравнить два варианта AGENTS.md. В экспериментальной копии уберите дубли README и документации, сохранив уникальные ограничения и критерии готовности.
Дайте агенту одинаковые задачи с исходным и сокращённым файлом. Остальную конфигурацию оставьте прежней.
Сравните принятые патчи, затраты и соблюдение ограничений. Одного прохождения тестов недостаточно для оценки качества.
Ограничение: Исследование проводили на Python. Отдельный эффект удаления дублей не доказан; для Go это проверка гипотезы, а не обещание выигрыша.
Рисунок 3 из приложенного PDF: None — без контекстного файла, LLM — со сгенерированным, Dev — с инструкциями разработчиков. Слева SWE-bench, справа CTXBench; общего выигрыша для всех связок нет.
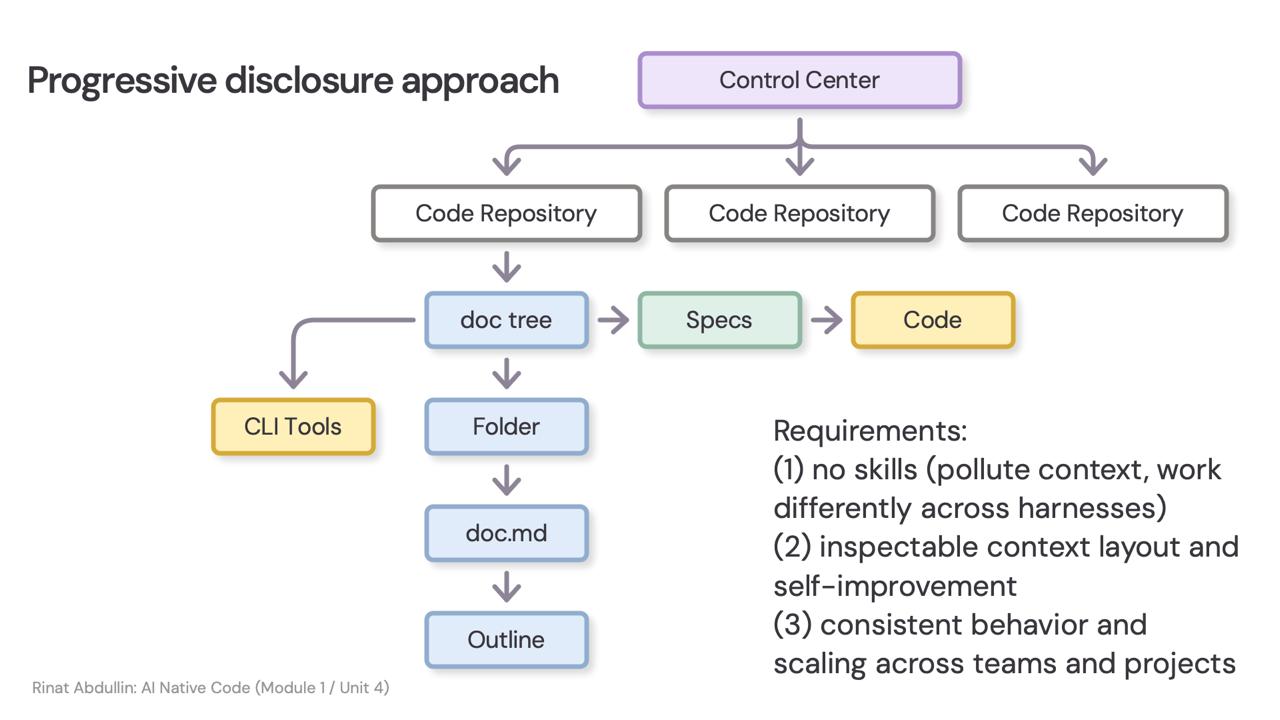
Суть: Если вся документация попадает в каждый запрос, агент получает и ненужные для задачи сведения. Ринат Абдуллин показывает progressive disclosure — постепенное раскрытие контекста. В его схеме агент идёт от дерева документов к нужному файлу и оглавлению; отдельная ветка ведёт к спецификации и коду.
Почему важно: Дерево даёт агенту маршрут к подробностям без загрузки всех документов сразу. Автор использует этот подход вместо skills; в своём проекте можно проверить его на одном модуле.
Как применить
Сделайте для выбранного модуля индекс документов со ссылками на подробные разделы. Отдельно укажите путь к спецификации и коду.
Дайте агенту задачу и попросите начать с индекса, открывая документы по необходимости.
Сравните с прежним способом на той же задаче: какие файлы прочитаны, какие требования пропущены и принят ли результат.
Ограничение: В посте есть схема, но нет готовых файлов, команд загрузки и протокола сравнения со skills. Предложенный опыт — наша адаптация; его результат ещё нужно измерить.
На схеме маршрут идёт от Control Center к репозиторию и дереву документов, затем к папке, файлу doc.md и его оглавлению. Другие ветки ведут к CLI Tools, спецификации и коду.
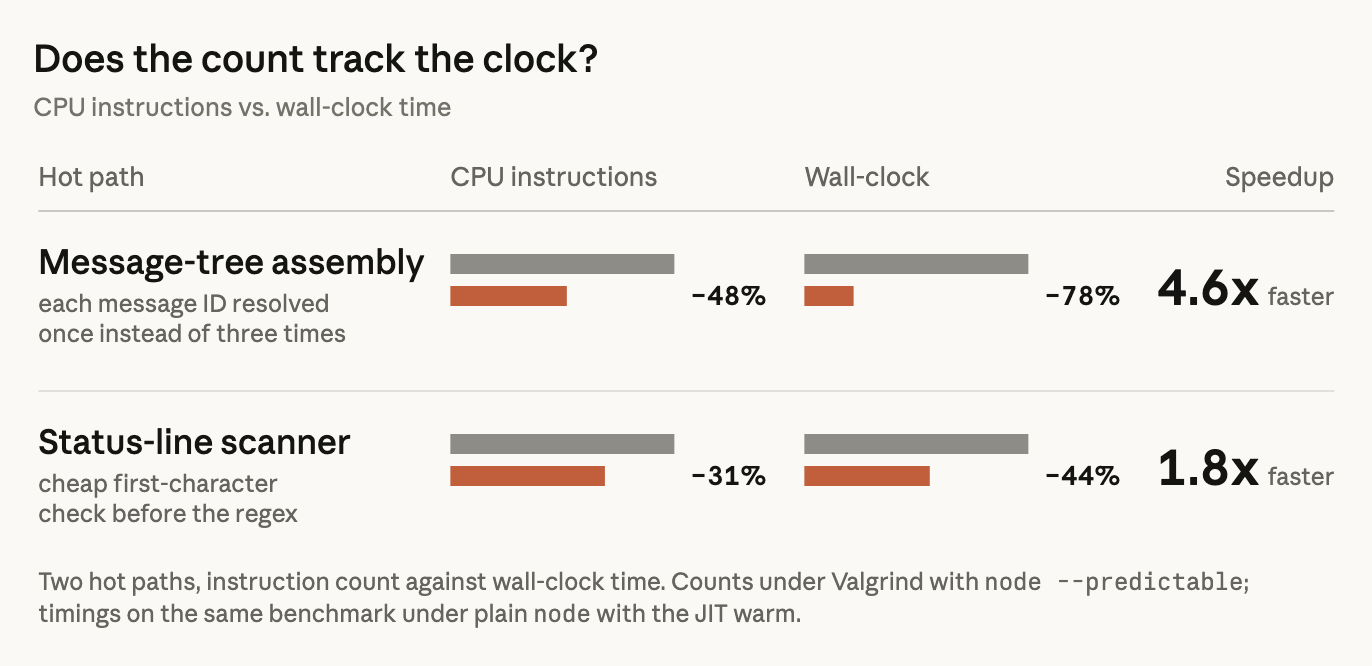
Суть: Когда claude.ai и десктопное приложение тормозили, Anthropic поручили агенту искать узкие места, писать benchmark и предлагать патчи. Чтобы последующие изменения не вернули задержки, команда добавила проверки в CI. Для них выбрали стабильные счётчики, например число инструкций процессора, и проверили их связь со временем выполнения.
Почему важно: Агенту нужен измеримый результат, но уменьшение удобного счётчика ещё не означает ускорение для пользователя. Сначала нужно подтвердить связь метрики с задержкой и только затем запрещать её ухудшение в CI.
Как применить
В своём Go-сервисе выберите один горячий путь. Зафиксируйте воспроизводимый benchmark и задержку, которую хотите сократить.
Поручите агенту найти узкое место и предложить небольшой патч. Проверьте правильность патча, измерьте результат и проведите code review.
Сверьте изменение стабильного счётчика с задержкой. Добавляйте CI-проверку только для метрики, связь которой подтверждена.
Ограничение: Кейс относится к клиентскому приложению. Выигрыш Anthropic нельзя переносить на Go; шумное время выполнения само по себе плохо подходит для жёсткого CI-порога.
График Anthropic: на двух горячих путях число инструкций процессора и время выполнения уменьшились вместе. Их связь проверяли измерением на одном benchmark.
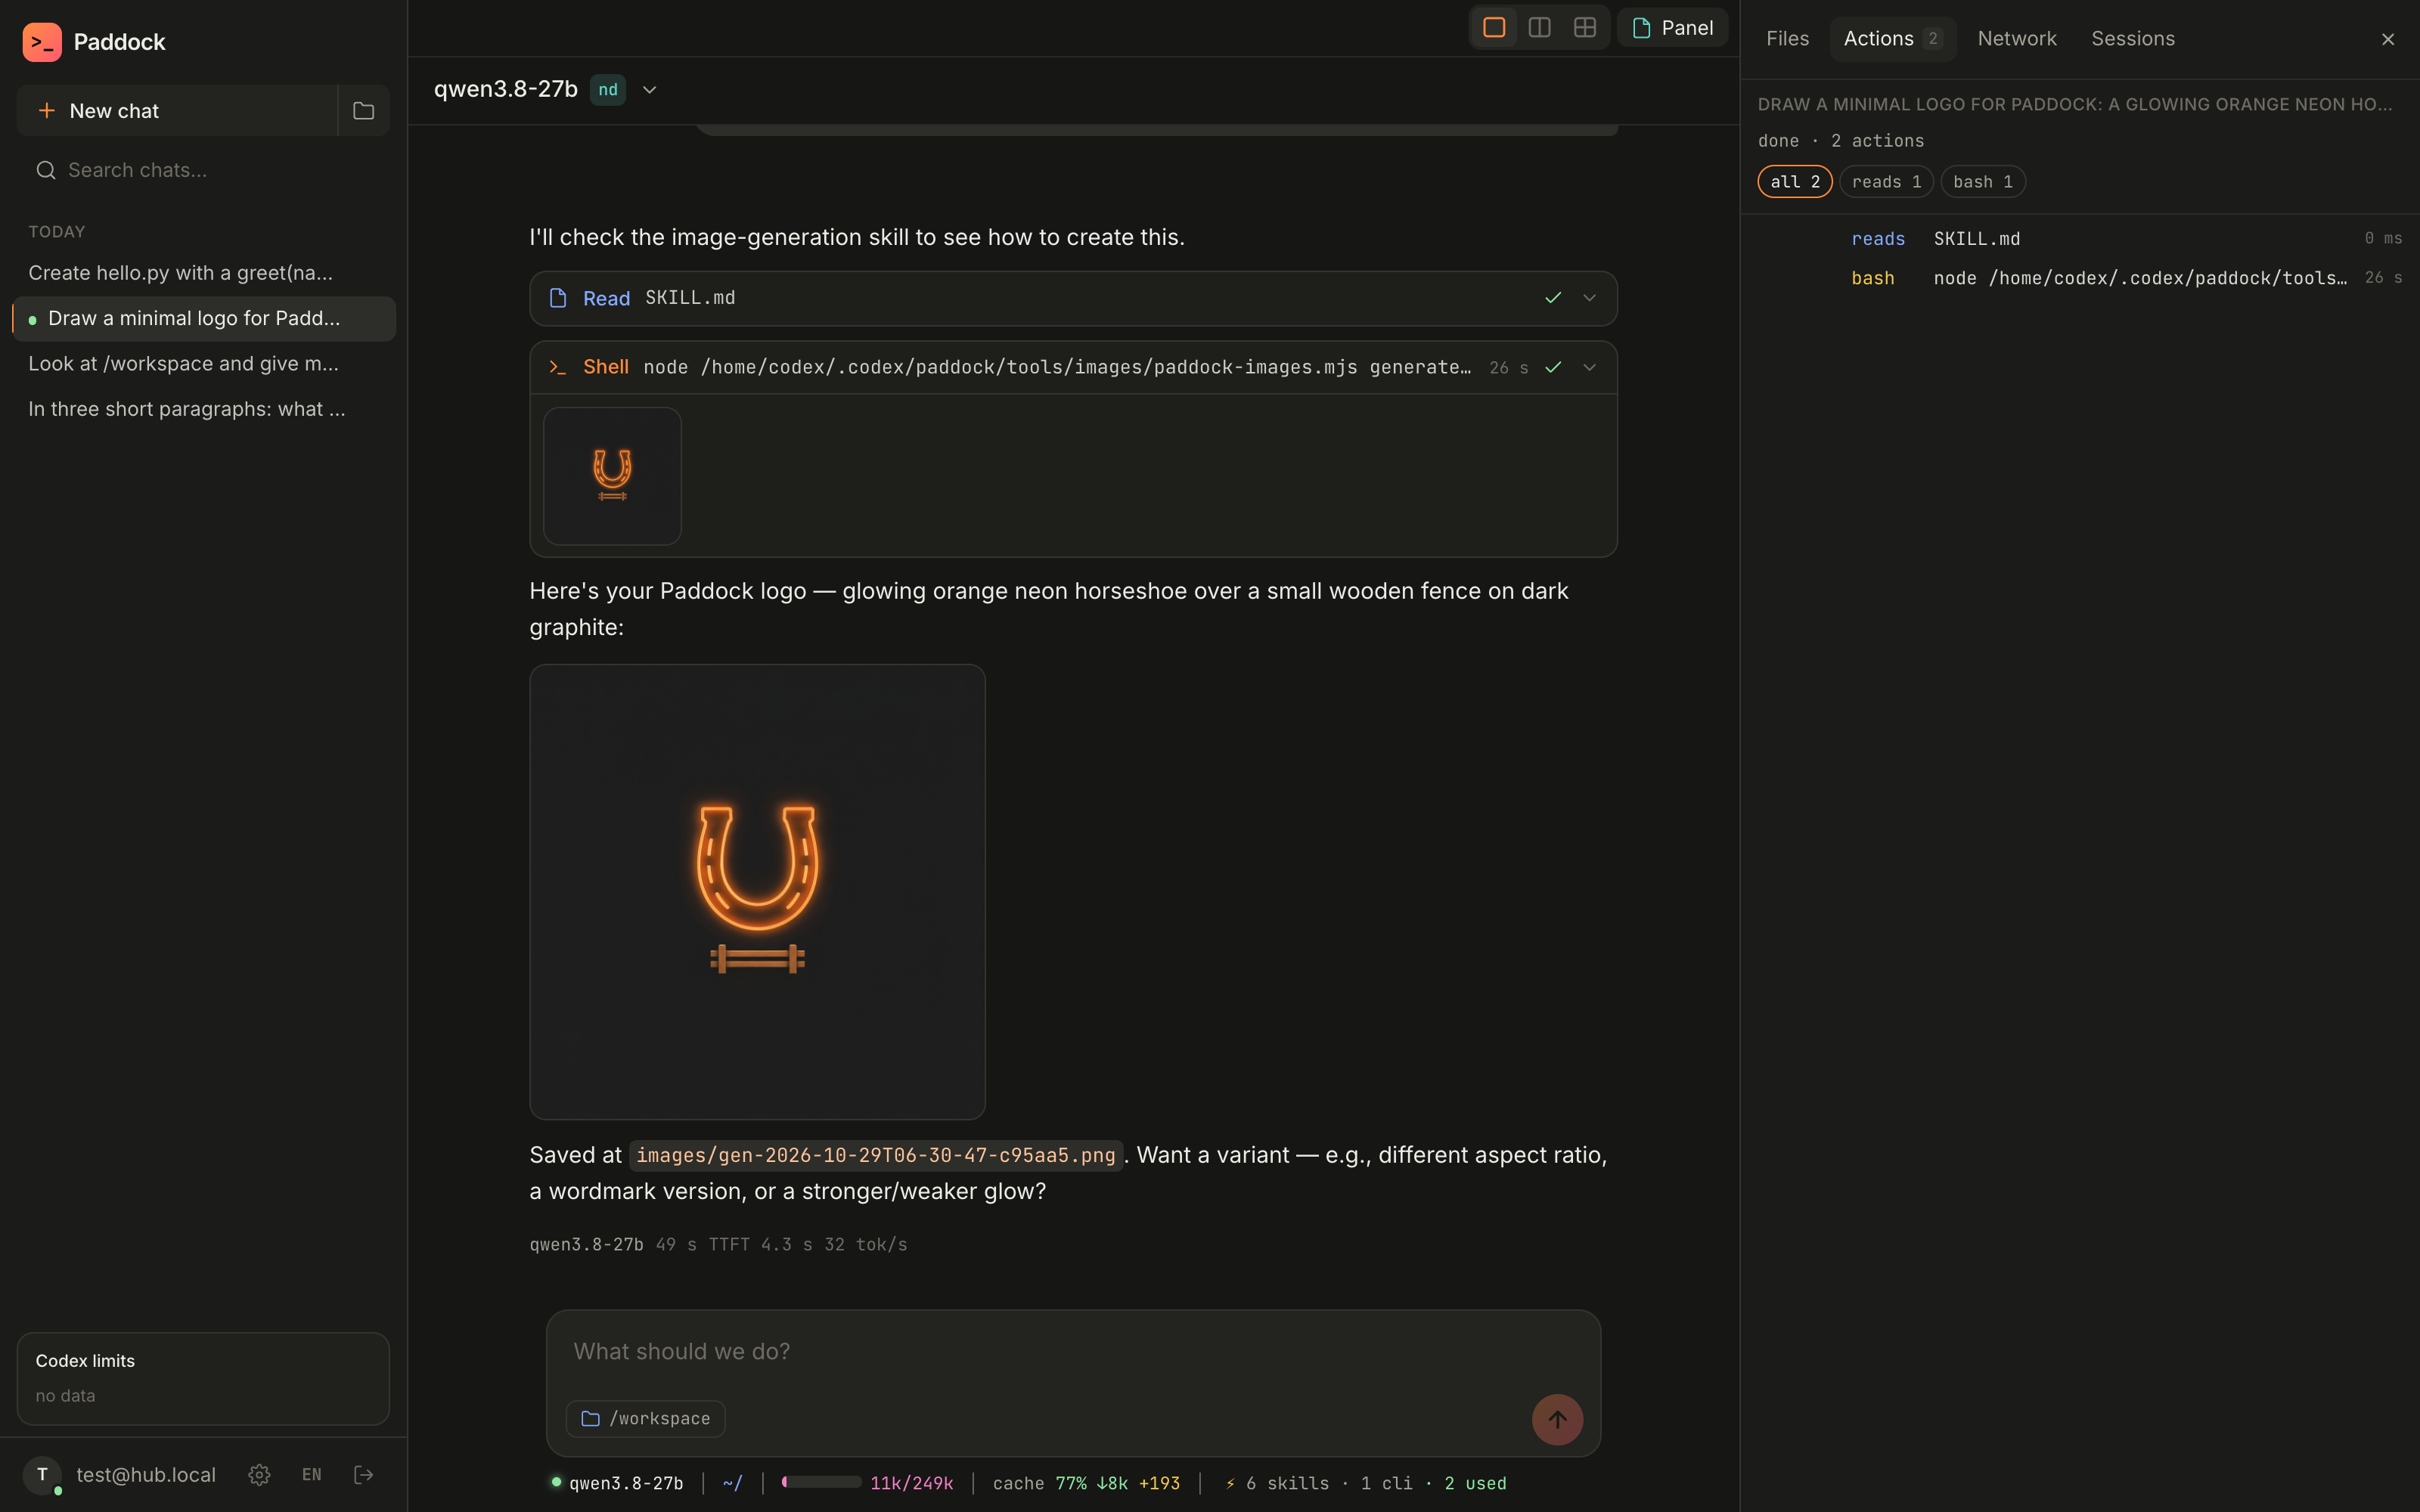
Суть: Автору Paddock было неудобно держать coding-агентов в терминалах ноутбука: после закрытия крышки работа останавливалась, а с телефона её было не видно. Он перенёс агентов на сервер в отдельный контейнер для каждого пользователя и сделал веб-интерфейс. В README описаны лента действий, 2FA и подтверждения опасных команд.
Почему важно: Так агент выполняет задачу на сервере, а пользователь подключается к нему из браузера с другого устройства. Лента действий позволяет проверить, какие файлы и команды использовал агент.
Как применить
Для проверки подхода поднимите тестовый Paddock по README с одним пользователем и одноразовым репозиторием без рабочих секретов.
Запустите короткую задачу, переподключитесь с другой вкладки и проверьте сохранение состояния и ленту действий.
Проверьте, что опасная команда требует подтверждения, а контейнер не получает прямой доступ к хосту и локальной сети.
Ограничение: Это авторский эксперимент; сейчас работает адаптер Codex. Прежде чем давать ему рабочий проект, нужно самостоятельно проверить изоляцию, восстановление сессии и подтверждения команд.
Скриншот из README: справа панель Actions показывает чтение SKILL.md и shell-вызов. Внизу видны модель, контекст, кеш и использованные инструменты.
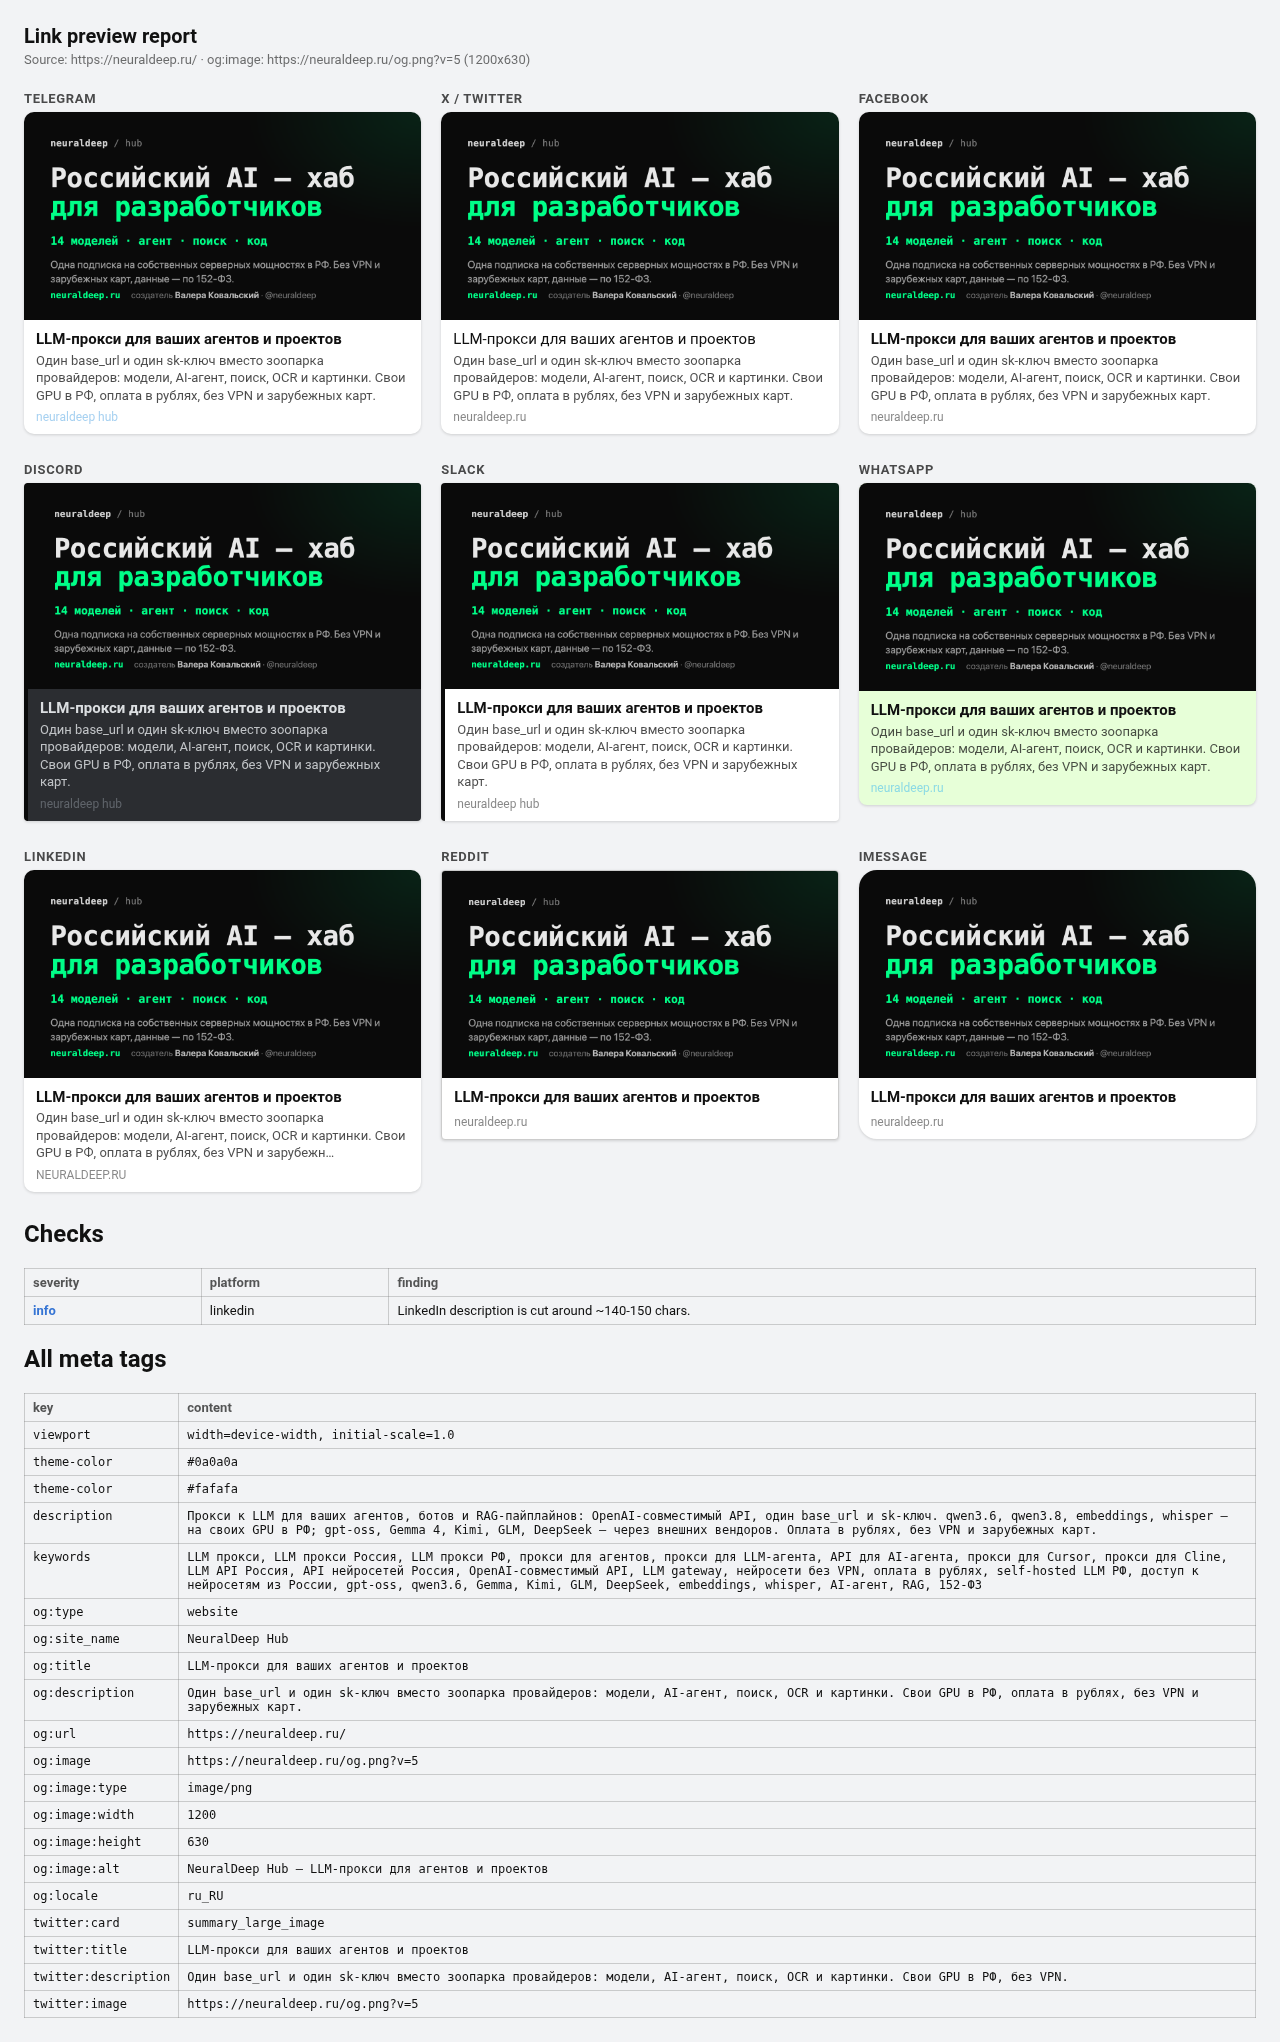
Суть: До публикации страницы нужно понять, как ссылка будет выглядеть в мессенджере, но внешний валидатор не видит localhost. Для этого автор написал og-preview — skill для coding-агента. Он принимает локальный URL или HTML-файл и строит отчёт с макетами карточек девяти платформ и замечаниями к метатегам Open Graph.
Почему важно: В одном отчёте можно заметить обрезанный заголовок, неподходящую картинку и другие проблемы превью. Проверка работает ещё до того, как страница станет доступна роботу платформы.
Как применить
В своём проекте передайте агенту локальный URL или HTML-файл и попросите запустить og-preview. В README есть команда python3 scripts/og_preview.py http://localhost:3000/blog/post.
Исправьте найденные проблемы: недоступное изображение, неверные размеры или обрезающийся текст.
Повторите отчёт и проверьте findings — список замечаний. Код завершения 1 при ошибках позволяет добавить проверку в CI.
Ограничение: Отчёт имитирует правила платформ. Реальное превью может отличаться; обновление кеша Telegram после публикации этот инструмент не гарантирует.
Пример отчёта из README: девять вариантов превью, таблица проверок и найденные метатеги. Для LinkedIn отчёт отмечает риск обрезки описания.
Суть: В Claude Code установленный плагин иногда не загружается, и агент не видит нужные skills. Автор написал plugin-rollcall: он сверяет плагины на старте и при неполной загрузке вызывает их перезагрузку средствами Claude Code. Решение работает только в интерактивных сессиях.
Почему важно: Если задача зависит от skill, его доступность нужно проверить до запуска работы. Иначе агент начнёт решать задачу без инструкции, на которую рассчитывает пользователь.
Как применить
Для проверки подхода откройте отдельную интерактивную сессию Claude Code и сверьте ожидаемые плагины с доступными skills.
Если воспроизводится описанный сбой, испытайте plugin-rollcall@foundry из поста. После перезагрузки повторите сверку.
Вызовите нужный skill и проверьте, что он доступен. Пропущенные startup hooks — действия при старте сессии — учитывайте отдельно.
Ограничение: В посте нет команды установки. Перезагрузка не возвращает пропущенные startup hooks и не помогает неинтерактивным сессиям.
Сравнить исходный skill, обновлённый и работу без него
Чтобы понять пользу правки skill, автор предлагает сравнить три варианта: исходный skill, обновлённый и работу без него. Такой опыт дополняет разбор шагов агента. Готовой обвязки для eval в посте нет.
Herd — десктопный клиент для агентов — обещает сохранять терминальные сессии после закрытия окна. Автор только начинает его проверять. Приложение и терминальный интерфейс TUI не используют общие сессии агентов.
Хранилище с версиями данных для нескольких агентов
Автор переписал хранилище с версиями данных для нескольких агентов и сообщает о резком сокращении его размера. В посте нет патча и описания данных, на которых получен результат, поэтому повторить сравнение пока нельзя.
В интервью предлагают дать агенту отдельную экспериментальную БД, ограничить права и использовать ветки БД. Готовой настройки для конкретной СУБД нет; изоляцию от рабочих данных придётся проверять самостоятельно.
Прочитаны все 72 поста собранного корпуса. В основные карточки вошли 9; ещё 25 остались на радаре отбора, из них выше показаны четыре. Отклонены 38: афиши, реклама, мемы, общие рассуждения и материалы без подтверждённого действия. При сборе отдельно сняты пять точных повторов между каналами и восемь сообщений без подписи.
План на неделю
Найти причину одной повторной ошибки агента в записях сессий и проверить исправленное правило или hook.
до среды
Повторить задачу с новым skill в свежей сессии. Убрать лишний переход и проверить, что ответ остался правильным.
до четверга
Сравнить две конфигурации агента на одном наборе задач: повторить прогоны, записать результат, разброс и затраты.
до пятницы
Метаданные
Сбор: 2026-11-02T07:43:37.270053Z
Окно: 27 октября — 2 ноября 2026, семь полных суток UTC. Источник: живой tdl chat export, последовательно по chat_id.
Из 20 каналов посты были у 18. Молчали AI RANEZ и Aimasters.Me. Недоступных каналов нет.
В выпуск мог попасть материал старше недели, если на него ссылается новый Telegram-пост. Дата карточки относится к посту. Предложения для своего проекта — редакционная адаптация; их эффект редакция не измеряла.